[Alle Hervorhebungen im Original]
Man stelle sich vor, ich schreibe ein Computerprogramm, um ein Pferderennen zu simulieren. Dann schreibe ich ein weiteres Computerprogramm, um vorherzusagen, welches simulierte Pferd gewinnen wird.
Mein zweites Programm funktioniert hervorragend. Es sagt den Sieger, die Zielzeit und einfach alles voraus.
Habe ich herausgefunden, wie man auf der Rennbahn Geld verdienen kann?
Nun ja … bevor man sein Haus verpfändest und sich auf den Weg zur Wettannahmestelle macht, gibt es da noch eine Kleinigkeit, die wir vielleicht untersuchen sollten.
Hat mein simuliertes Pferderennen irgendetwas mit echten Pferden zu tun?
Behalten wir diese Frage mal im Hinterkopf.
Bei meinen chaotischen Streifzügen durch das Internet stieß ich auf einen Artikel mit folgender Überschrift und Unterüberschrift:
Von Caltech geleitetes Team treibt die Entwicklung von KI-Modellen zur Vorhersage irreversibler Veränderungen voran
Von Caltech geleitete Forscher machen entscheidende Fortschritte bei der Entwicklung von Deep-Learning-Modellen, die irreversible Veränderungen im Klima und in anderen Systemen vorhersagen können.
Der Artikel befasst sich mit einer kürzlich in den „Proceedings of the National Academy of Sciences“ veröffentlichten Arbeit, die den etwas schwerfälligen Titel „Tipping point forecasting in nonstationary dynamics on function spaces“ trägt [etwa: Prognose von Wendepunkten in nichtstationärer Dynamik auf Funktionsräumen].
Hier die Kurzfassung: Die Autoren haben ein Verfahren auf Basis künstlicher Intelligenz entwickelt, mit dem sich „Kipppunkte“ vorhersagen lassen – das sind abrupte Veränderungen in Systemen, die zu einem völlig neuen Zustand führen. Zu ihren Beispielen zählen das Verschwinden von Wolken in einem vereinfachten Atmosphärenmodell und aerodynamische Übergänge in der simulierten Strömung über einem Tragflügel.
Aus dem ersten Abschnitt der Arbeit:
„Während die meisten bisherigen Arbeiten Kipppunkte in einfacheren Systemen vorhersagen zeigen wir, dass unser Ansatz bei groß angelegten, komplexen Problemen funktioniert, darunter die Vorhersage eines klimatischen Kipppunkts bei der Wolkendecke und aerodynamischer Instabilität bei Tragflächen.“
Sie können „einen klimatischen Kipppunkt bei der Wolkendecke“ vorhersagen?, frage ich mich. Erstaunlich, wenn das stimmt!
Auf Seite 3 steht das hier:
„Mit unserem vorgeschlagenen Verfahren lassen sich auch reale Kipppunkte, wie beispielsweise der bereits erwähnte Übergang der Wolkendecke, vorhersagen, wobei lediglich Teilkenntnisse der zugrunde liegenden physikalischen Zusammenhänge herangezogen werden …“
Das ist mir ins Auge gefallen. „Kipppunkte in der realen Welt“?, dachte ich mir. Klingt vielversprechend! Wie machen die das bloß?
Also habe ich die Abhandlung und die 38 Seiten mit ergänzenden Informationen gelesen – und am Ende hatte ich mehr Fragen als Antworten.
Wo waren die Tests unter realen Bedingungen? Wo wurden die Wolkenvorhersagen mit gemessenen atmosphärischen Veränderungen abgeglichen? Oder, wenn wir schon dabei sind, ein Tragflügel im Windkanal?
Nirgendwo in den beschriebenen Experimenten!
Ihre Behauptungen über Vorhersagen unter realen Bedingungen entpuppen sich als „Vaporware“. Tatsächlich verwenden sie ein Computerprogramm, um vorherzusagen, was ein anderes Computerprogramm tun wird. Das ist nicht nur meilenweit davon entfernt, das tatsächliche Klima vorherzusagen – es ist eine ganz andere Welt.
Nun, ich will damit nicht sagen, dass das nutzlos ist. Die Methode der Autoren ist clever genug, um eine Erklärung zu verdienen.
Sie trainieren einen „rekurrenten neuronalen Operator“, den ich der Einfachheit halber „KI“ nennen werde. Er lernt, wie sich ein simuliertes System vor einem Kipppunkt verhält. Die KI sagt dann die zukünftige Entwicklung des Systems voraus.
Wie stellen sie fest, dass sich ein Kipppunkt nähert, ohne die Zukunft zu kennen?
Sie gleichen die Vorhersagen der KI mit ausgewählten physikalischen Randbedingungen ab. Im Beispiel mit der Wolke verwenden sie eine Massenerhaltungsbedingung. Beim Beispiel mit der Luftströmung prüfen sie, ob die vorhergesagte Strömung die Gleichungen für inkompressible Strömung erfüllt. Wenn die Abweichung groß genug wird, wird ein Alarm ausgelöst.
Im Klartext: Die KI hat das alte Regime gelernt. Wenn sie aufgefordert wird, Prognosen für ein unbekanntes Regime zu erstellen, können ihre Vorhersagen an allen Ecken und Enden zusammenbrechen. Die Autoren nutzen dieses Zusammenbrechen der KI-Vorhersagen als Warnsignal.
Dabei gibt es eine offensichtliche Komplikation. Eine KI kann eine falsche Vorhersage treffen, ohne dass ein physikalischer Kipppunkt in Sicht ist.
Die Autoren räumen dies ein:
„… dieser Ansatz macht Fehler und verwechselt große Abweichungen in Zuständen vor dem Kipppunkt mit tatsächlichen Kipppunkten.“
In der Tat.
Sie gehen das Problem an, indem sie einen Alarm-Schwellenwert anhand der Verteilung der Vorhersagefehler vor dem Kipppunkt kalibrieren. Dadurch erhält der Schwellenwert eine statistische Interpretation. Eine nützliche Arbeit. Aber wir werden gleich noch einmal auf die Alarme zurückkommen, denn die Beilage enthält eine recht aufschlussreiche Diskussion darüber.
Betrachten wir zunächst den vermeintlichen Klimatest. Das Wolkenexperiment verwendet fünf gekoppelte gewöhnliche Differentialgleichungen. Sie repräsentieren die Grenzschichttiefe, die statische Energie des flüssigen Wassers, die spezifische Feuchte des Gesamtwassers, den Wolkenanteil und die Meerestemperatur.
Fünf Variablen. Ein kompaktes Modell einer von Wolken bedeckten atmosphärischen Grenzschicht.
Daran ist nichts auszusetzen. Einfache Modelle können uns helfen, herauszufinden, wie die Dinge funktionieren könnten.
Aber ein Modell mit fünf Variablen ist nicht der Ozean und die Atmosphäre, die ich von meinem Küchenfenster aus sehen kann, und es wird auch nicht zu einem solchen, nur weil wir einer KI beibringen, es nachzuahmen.
Die Veröffentlichung selbst ist recht eindeutig:
„Wir verwenden das in den Referenzen 3 und 4 entwickelte ODE-Modell als Idealisierung des physikalischen Klimasystems; dieses Modell weist einen Kipppunkt auf.“
Beachten Sie die letzten sechs Wörter: dieses Modell weist einen Kipppunkt auf.
Die Aufgabe der KI besteht darin, den Wendepunkt dieses Modells vorherzusagen, also seinen Übergang in einen neuen Zustand.
Die Autoren generieren 150 simulierte 20-Jahres-Verläufe. 45 davon fließen in das Training ein, 100 in die Kalibrierung und fünf in den Test. Alle werden durch numerische Integration der Gleichungen des Wolkenmodells erzeugt.
Der Testdatensatz enthält vom Computermodell erzeugte Wolkenkollaps-Ereignisse – und keine solche in der tatsächlichen Atmosphäre gemessenen. Die fünf Testverläufe sind Simulationen.
Nun wird jemand zu Recht einwenden, dass das Wolkenmodell Beobachtungsdaten enthält. Ganz richtig. Im Anhang heißt es, dass die Parameter in den empirischen Formulierungen auf Satellitenbeobachtungen oder hochauflösenden Simulationen basieren. Einige Parameter zur Wolkenbedeckung werden an frühere Daten angepasst.
Das verdient Anerkennung. Es handelt sich hier nicht um ein Modell, das ausschließlich aus Luftschlössern zusammengesetzt ist.
Aber: das Anpassen von Modellteilen an Beobachtungen ist jedoch nicht das Gleiche wie das Überprüfen der Kipppunkt-Prognosen der KI anhand unabhängiger Beobachtungen. Ersteres kann dabei helfen, einen plausiblen Simulator zu erstellen. Letzteres zeigt uns, ob das Prognoseverfahren auch außerhalb des Simulators funktioniert.
Dieser zweite Test fehlt. Sie prüfen lediglich, ob ein Modell ein Modell vorhersagen kann.
Die Arbeit wirbt mit einer Vorhersage des Wolkenübergangs fast zweieinhalb Jahre im Voraus, mit einer Abweichung von „nur 10 Tagen“. Abbildung 5 gibt eine Abweichung von 0,03 Jahren, also etwa elf Tagen, bei einem Vorhersagehorizont von 2,45 Jahren an.
Das klingt beeindruckend. Und innerhalb des Experiments ist es das auch.
Aber elf Tage ab wann?
Ab dem Übergangsdatum im Computermodell.
Nicht ab dem Datum, an dem eine tatsächliche Wolkendecke aufgrund steigender CO₂-Konzentrationen verschwunden ist. Nicht ab einem gemessenen Ereignis, das den Forschern bewusst vorenthalten worden ist.
Die Autoren beschreiben Abbildung 5 als Darstellung von Ergebnissen für „eine bestimmte Testtrajektorie“. Der Anhang enthält Vergleiche mit unterschiedlichen Alarmeinstellungen sowie ein weiteres Beispiel, bei dem der vollständige Satz von Wolkengleichungen als physikalische Nebenbedingung verwendet wird. Dabei handelt es sich um zusätzliche numerische Tests, nicht um zusätzliche Beobachtungen der Erde.
Um auf meinen Ausgangspunkt zurückzukommen: Mein KI-Pferderennen-Prognostiker könnte die Zielzeit auf die Hundertstelsekunde genau vorhersagen. Das zeigt, wie gut er mit meinem Pferderennen-Simulator übereinstimmt.
Ob man damit auf die Rennbahn gehen und echtes Geld auf die Vorhersagen setzen sollte, ist eine ganz andere Frage.
Die elf Tage lassen die Unsicherheit bezüglich des Wolkenmodells selbst außer Acht. Findet der vorgeschlagene Übergang in der Natur tatsächlich so statt, wie dargestellt? Bei welcher CO₂-Konzentration? Wie verändert sich sein zeitlicher Verlauf, wenn man die Annahmen des Modells ändert?
Die Übereinstimmung der KI mit dem Simulator beantwortet diese Fragen nicht.
Hier ist eine experimentelle Entscheidung, die es zu beachten gilt:
Die vorgegebene CO₂-Entwicklung beginnt bei 400 ppm und steigt um konstante 10 % pro Jahr, ergänzt durch eine zufällige Störung. Zehn Prozent jährlich sind die gewählten Eingabewerte für dieses Computerexperiment. Die viel zitierten „2,45 Jahre Vorsprung“ beziehen sich also auf ein System, das entlang dieser speziellen Entwicklung verläuft.
Behält die KI ihre Genauigkeit von elf Tagen auch bei erheblich abweichenden CO₂-Anstiegsraten bei? Der Anhang untersucht sich ändernde Antriebsraten in den Tragflächenversuchen. Er enthält jedoch keine entsprechende Untersuchung der CO₂-Anstiegsraten für die Wolkenvorhersagen.
Es gibt noch ein weiteres Problem mit diesem Szenario. Es legt fest, dass der CO₂-Gehalt um 10 % pro Jahr steigt. Da ich in meiner bewegten Vergangenheit als Buchhalter gearbeitet habe, bin ich mit der sogenannten „70er-Regel“ vertraut. Sie besagt, dass die Verdopplungszeit in Jahren bei Zinseszinsen in etwa siebzig geteilt durch den Zinssatz entspricht.
Wenn also der CO₂-Gehalt in der Modellwelt um zehn Prozent pro Jahr zunimmt, beträgt die Verdopplungszeit etwa sieben Jahre … doch hier in der realen Welt lag der CO₂-Gehalt im Jahr 1850 bei etwa 285 ppmv … und heute liegt er bei etwa 430 ppmv. In den 175 Jahren seit 1850 hat sich der CO₂-Gehalt also noch immer nicht verdoppelt.
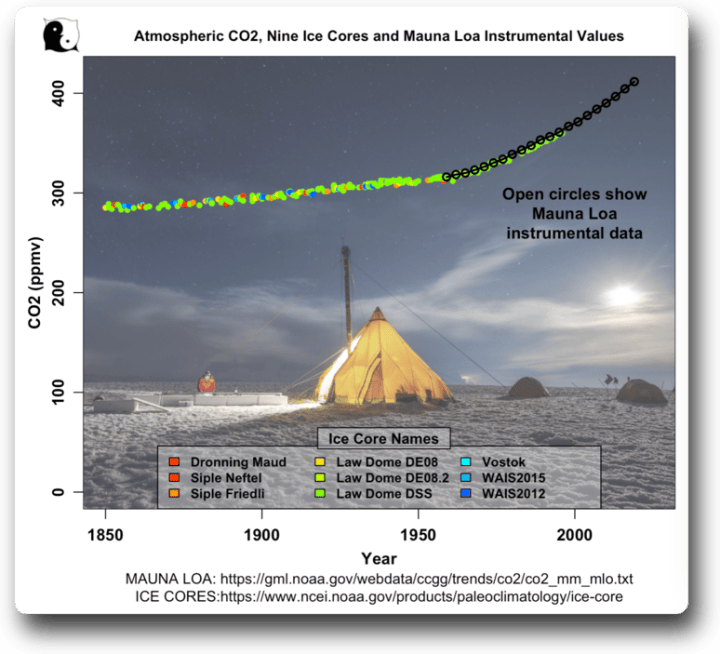
Abbildung 1. CO₂-Konzentrationen aus geeigneten Eisbohrkernen und aus den Daten des Mauna-Loa-Observatoriums, 1850–2023
Ihr Modell beginnt bei 400 ppmv, und die Simulationsläufe dauern 20 Jahre. Das bedeutet also, dass der CO₂-Gehalt in der Atmosphäre am Ende der Simulation bei 2.691 ppmv liegt … weit über dem Wert, den wir hätten, wenn wir jeden Rest fossiler Brennstoffe im Boden verbrennen würden.
„Realistische“ Prognosen, von wegen …
Dann ist da noch der Ozean.
Dieses Modell geht von einem einen Meter tiefen Plattenozean aus. Die Autoren bezeichnen die Tiefe als willkürlich und erklären, dass sie zwar die Zeit bis zum Erreichen des Gleichgewichts, nicht aber die Ergebnisse dieses Gleichgewichts verändert. Sie begründen diese Wahl damit, dass die Antriebskraft im Vergleich zu ihrer etwa fünfzig Tage betragenden Zeitspanne bis zum Erreichen des Gleichgewichts langsam ist. Die Wärmeaufnahme des Ozeans wird so eingestellt, dass bei 400 ppm CO₂ eine Meerestemperatur von 290 K erreicht wird, und wird anschließend konstant gehalten.
Das mag für die Untersuchung der Gleichungen eine durchaus brauchbare Vorgehensweise sein.
Aber Moment mal. Wenn die angepriesene Leistung darin besteht vorherzusagen, wann etwas geschieht, ist eine Wahl, welche die Einstellzeit beeinflusst, eine Untersuchung wert.
Ich behaupte nicht, dass ein tieferer „Slab-Ozean“ ihre Vorhersage zwangsläufig zunichte machen würde. Das haben sie nicht gezeigt, und ich auch nicht.
Ich meine damit, dass die elf Tage dauernde Übereinstimmung in diesem Modell nicht mit einer Genauigkeit von elf Tagen im realen Klima verwechselt werden sollte. Der zeitliche Ablauf wurde unter diesen Annahmen getestet. Wir können diese Annahmen nicht einfach ausblenden, wenn wir das Ergebnis bekanntgeben.
Aber das war alles nur der Auftakt. Dies war die Passage im Anhang, die mich innehalten und nachdenklich werden ließ:
„Wir stellen fest, dass es aufgrund der Konzeption schwierig ist, die Vorhersage eines Kipppunkts für ein Signifikanzniveau α zu vermeiden, das größer ist als der minimal zulässige Wert, wenn die Auswertungs-Trajektorie ausreichend lang ist.“
Lesen Sie das noch einmal.
Bei einem ausreichend langen Zeithorizont generiert das System eine Vorhersage zum Wendepunkt, außer bei der konservativsten zulässigen Einstellung.
Das sind ganz schön hohe Anforderungen an ein Frühwarnsystem.
Ein Rauchmelder, der einen Brand korrekt meldet, ist nützlich. Bevor ich ihn jedoch installiere, würde ich gerne wissen, wie oft er mich um drei Uhr morgens wecken wird, weil er philosophische Zweifel am Toaster hegt.
Die statistische Terminologie lässt dieses praktische Problem nicht verschwinden. Eine Begrenzung der individuellen Wahrscheinlichkeit einer Überschreitung des Schwellenwertes wird das System nicht davon abhalten, im Laufe jahrelangen wiederholten Betriebs irgendwann einen Fehlalarm auszulösen. Die Warnung in der Beilage selbst macht deutlich, dass wir das in der Arbeit beschriebene „strenge Maß für Unsicherheit“ nicht als Allzweckgarantie verstehen sollten.
Im Nachtrag wird folgender Rat gegeben:
„Wenn repräsentative Trajektorien mit bekannten Kipp-Ereignissen vorliegen, können Fachleute den Alpha-Wert daher empirisch festlegen, um vor der Inbetriebnahme die gewünschten Betriebseigenschaften zu erreichen.“
Das leuchtet ein. Wenn bekannte Ereignisse vorliegen, sollten diese zur Auswahl einer sinnvollen Alarmeinstellung herangezogen werden.
Abgesehen davon, dass das Hauptverkaufsargument dieses Verfahrens in der behaupteten Fähigkeit liegt, ohne tatsächliche Kipppunktdaten aus Beobachtungen in der realen Welt zu testen. Der Grund für die Entwicklung des Verfahrens ist das Fehlen jeglicher verfügbarer historischer Aufzeichnungen über einen Kipppunkt beim Zusammenbruch von Wolken.
Im engen technischen Sinne besteht kein Widerspruch. Das Trainieren der KI und die Festlegung eines operativen Alarmschwellenwerts sind unterschiedliche Aufgaben.
Doch die praktische Schwierigkeit bleibt bestehen. Wir haben noch nie einen Klima-Kipppunkt der Art beobachtet, wie er in ihrem Modell simuliert wird. Wenn man keine repräsentativen physikalischen Ereignisse hat, woher weiß man dann, welche Einstellung eine nützliche Frühwarnung liefert, ohne dass es zu einer inakzeptablen Flut von Fehlalarmen kommt?
Als Nächstes gibt es einen weiteren Punkt, den man klar vor Augen behalten sollte.
Der Alarm wird ausgelöst, wenn eine Vorhersage gegen eine ausgewählte physikalische Bedingung verstößt. Die tatsächliche Atmosphäre hört nicht auf, Masse zu bewahren, wenn sich Wolken verändern. Ebenso wenig gibt ein inkompressibler Luftstrom seinen divergenzfreien Zustand auf, wenn ein Tragflügel in den Strömungsabriss gerät.
Die Prognose der KI besagt, dass die Lage aus dem Ruder laufen wird.
Das kann aufschlussreich sein. Es handelt sich jedoch nicht um einen eindeutigen Fingerabdruck eines Kipppunktes.
Die Autoren untersuchen verschiedene Möglichkeiten, wie ihr Verfahren fehlschlagen könnte. Eine nützliche Arbeit. Doch diese Computerexperimente beweisen nicht, dass sich damit ein sich nähernder realer Kipppunkt von einer fehlerhaften Vorhersage unterscheiden lässt, die auf fehlende physikalische Erkenntnisse, ungenaue Beobachtungen oder Wolken zurückzuführen ist, die das Modell nur unzureichend berücksichtigt.
Auch die Einhaltung einer einzigen physikalischen Regel macht eine Vorhersage noch nicht richtig. Man kann jedes einzelne Gramm Wasser berücksichtigen und dennoch die Wolkendecke hoffnungslos falsch einschätzen. Den „Buchhaltungstest“ zu bestehen, bedeutet nicht, dass man das Wetter verstanden hat.
Also ja, das Verfahren liefert in diesen Computerexperimenten nützliche Warnsignale. Ob diese Signale zuverlässig vor Kipppunkten im tatsächlichen Klima warnen, muss noch getestet werden.
Also … was würde mich davon überzeugen, dass dieser Ansatz einen gewissen Wert hat?
Tatsächliche Validierung.
Testen Sie die Methode anhand von Messwerten eines physikalischen Systems vor einem Übergang. Legen Sie das Prognoseverfahren und die Alarmeinstellungen fest. Testen Sie das Modell anschließend an unabhängigen physikalischen Fallbeispielen.
Geben Sie an, wie früh die Warnungen eintreffen. Zeigen Sie die Fehlprognosen auf. Zählen Sie die Fehlalarme über lange Zeiträume ohne Systemwechsel. Berichten Sie über die zeitlichen Abweichungen über alle Fallbeispiele hinweg, anstatt nur eine besonders aussagekräftige Entwicklung als Beispiel heranzuziehen.
Für die Klimaanwendung sollte die Sensitivität gegenüber der Antriebs-Historie, der Ozeandarstellung, den Wolkenparametrisierungen und den Beobachtungsbeschränkungen getestet werden. Ein Test mit einer Modellformulierung und ein Test mit einer anderen wäre ebenfalls aufschlussreich – auch wenn es sich dabei immer noch um einen Modell-zu-Modell-Test handeln würde.
Die Autoren selbst räumen ein, dass spärliche oder niedrig aufgelöste Daten die KI daran hindern können, die zugrunde liegende Entwicklung richtig zu erlernen. Sie warnen davor, dass ungelöste physikalische Probleme das Lernproblem schlecht darstellen können.
Ja. Genau. Diese Schwierigkeiten sind Teil des realen Problems und keine Unannehmlichkeiten, auf die wir verzichten können, nur weil der Simulator sauberere Daten liefert.
Und es gibt noch ein tiefer liegendes Problem.
Wir haben nur sehr wenige Beispiele für klimatische „Kipppunkte“ – Momente, in denen eine bestimmte Schwelle überschritten wird, die zu einem völlig neuen System führt. Der in dieser Studie untersuchte „Kipppunkt“ bei niedrigen Wolken wurde beispielsweise noch nie beobachtet. Das macht es außerordentlich schwierig, eine solche KI-Methode zur Vorhersage klimatischer „Kipppunkte“ überhaupt zu testen.
Es stimmt zwar, dass Laborsysteme und physikalische aerodynamische Experimente Möglichkeiten bieten, die vorgeschlagene Methode anhand bestimmter Aspekte der Natur zu überprüfen. Doch solange solche Tests nicht durchgeführt wurden, müssen sich die Behauptungen im Rahmen der vorliegenden Beweislage bewegen.
Leider sind Laborsysteme und aerodynamische Experimente in Bezug auf das reale Klima keine Hilfe. Uns fehlen schlichtweg die Beispiele, die wir benötigen, um das System zu testen.
Um es klar zu sagen: Diese Arbeit könnte sich als nützlich erweisen. Sie könnte zu einer schnellen Methode werden, um Übergänge in aufwendigen Simulationen zu untersuchen. Möglicherweise lässt sie sich sogar irgendwann auf Beobachtungen anwenden. Die Autoren haben Code, Daten, Architekturvergleiche und einen Anhang bereitgestellt, in dem sie mehrere Einschränkungen einräumen. All das ist zu begrüßen.
Doch „könnte irgendwann“ leistet Arbeit, die „Kipppunkte in der realen Welt vorhersagen kann“ – eine These, die stillschweigend verworfen wurde.
Sie haben einem Computerprogramm beigebracht, das Verhalten eines anderen Computerprogramms vorherzusagen.
Bevor wir dieses Ergebnis nutzen, um Rückschlüsse auf das tatsächliche Klima zu ziehen, müssen wir noch einen weiteren Akteur zu Rate ziehen: die reale Erde.
[CODA]: Nachdem ich all das oben Genannte geschrieben hatte und mich darauf vorbereitete, es auf WUWT zu veröffentlichen, wurde mir ein weiteres, bisher unberücksichtigtes Problem ihres Ansatzes bewusst. Die KI analysiert ein einfaches Klimamodell anhand computergenerierter Testdaten, und wenn die KI den Bezug zur physikalischen Realität verliert, führt sie dies darauf zurück, dass es in den Daten einen „Kipppunkt“ gab.
Das Problem ist, dass aktuelle Klimamodelle ständig von der physikalischen Realität abweichen. Hier ist ein Auszug aus meinem Beitrag „Meandering Through A Climate Muddle“. In diesem Beitrag habe ich mir den Quellcode eines der bekannteren Klimamodelle angesehen, nämlich das Modell E des Goddard Institute for Space Studies (GISS). In den Kommentaren zum Quellcode erklären ein oder mehrere Programmierer genau, an welchen Stellen es zu Abweichungen kommt und wie damit umgegangen wird. Spoiler: Es wird nicht davon ausgegangen, dass es sich um einen Kipppunkt handelt … hier sind einige Beispiele, beginnend mit der Frage, wie die Albedo des Meereises bestimmt wird:
Das bedeutet, dass es einen Code gibt, um die Albedo des Meereises zu berechnen … aber manchmal liefert dieser Code unrealistische Werte. Doch anstatt herauszufinden, warum der Code falsche Werte liefert und das Problem zu beheben, ersetzt das Klimamodell den falschen Wert einfach durch den entsprechenden Maximal- oder Minimalwert. Wissenschaft vom Feinsten.
Hier ist ein Kommentar, der einen weiteren „Spaß“ mit Schmelzwasserteichen beschreibt:
C**** safety valve to ensure that melt ponds eventually disappear (Ti<-10)if (Ti1 .lt.-10.) pond_melt(i,j)=0. ! refreeze
Ohne diesen kleinen Code-Schnipsel würden einige der Schmelzwasserseen vielleicht nie wieder gefrieren, egal wie kalt es auch werden würde … man muss diese Art von Physik einfach lieben: Wasser, das nicht gefriert.
Genau das meinen die Klimamodellierer, wenn sie sagen, ihr Modell sei „physikalisch fundiert“. Sie meinen es im gleichen Sinne, wie wenn die Produzenten sagen, ein Hollywoodfilm basiere „auf einer wahren Geschichte“ …
Hier ist zum Beispiel ein großartiger Kommentar aus dem ModelE-Code (das „c“ oder das „!“ in einer Zeile kennzeichnet einen Kommentar):
!@sum tcheck checks for reasonable temperatures!@auth Ye Cheng/G. Hartke!@ver 1.0c ----------------------------------------------------------------------c This routine makes sure that the temperature remains withinc reasonable bounds during the initialization process. (Sometimes thec the computed temperature iterated out in left field someplace,c *way* outside any reasonable range.) This routine keeps the tempc between the maximum and minimum of the boundary temperatures.c ----------------------------------------------------------------------
Mit anderen Worten: Wenn die Temperatur aus dem Ruder läuft … sollte man nicht nach dem Grund suchen und das Problem beheben. Man stellt einfach eine vernünftige Temperatur ein und macht weiter.
Und was ist eine vernünftige Temperatur? Wie sich herausstellt, stellen sie sie einfach auf die Temperatur des vorherigen Zeitschritts ein und machen einfach weiter … Physik eben.
Hier ist noch ein Beispiel:
c ucheck makes sure that the winds remain within reasonablec bounds during the initialization process. (Sometimes the computedc wind speed iterated out in left field someplace, *way* outsidec any reasonable range.) Tests and corrects both direction andc magnitude of the wind rotation with altitude. Tests the totalc wind speed via comparison to similarity theory. Note that itc works from the top down so that it can assume that at level (i),c level (i+1) displays reasonable behavior.
… wenn das Klimamodell völlig entgleist und der Wind mit fünfhundert km/h weht, frag nicht nach dem Grund dafür. Stütz es einfach ab, setz es wieder auf die Gleise und fahr weiter …
Wie man sieht, wird das Problem, dass sich das Modell von der physikalischen Realität löst, dadurch gelöst, dass man es wieder auf den richtigen Kurs bringt, und nicht dadurch, dass man einen „Kipppunkt“ ausruft.
Mir ist außerdem aufgefallen, dass ich tatsächlich eine großartige Grafik zu Kipppunkten habe. Hier sind ein paar tausend Simulationsläufe für das Klimamodell von climateprediction.net. Für die historischen Phasen werden tatsächliche historische Daten ab 1850 als Eingabedaten für das Modell verwendet.
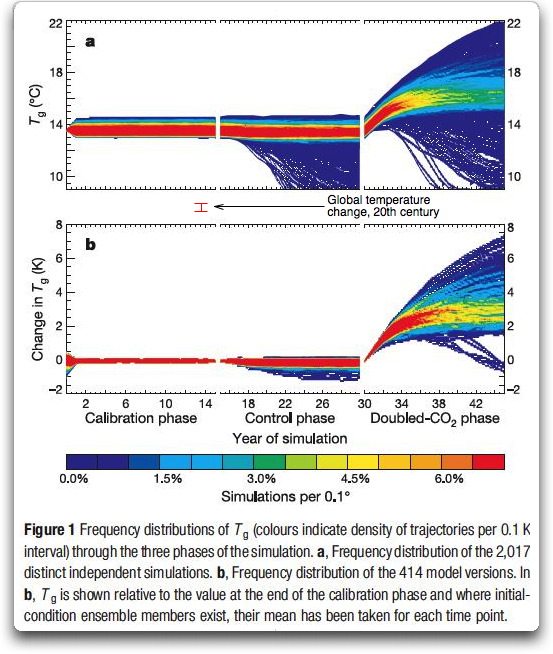
Abbildung 2. Kalibrierung, Modelljahre 1–15: Berechnung der Korrekturen für den Wärmetransport im Ozean für das vereinfachte Ozeanmodell. Kontrolllauf, Modelljahre 16–30: Simulation mit einem vorindustriellen CO₂-Gehalt von 280 ppm. Verdoppeltes CO₂, Modelljahre 31–45: Simulation mit einem CO₂-Gehalt von 560 ppm nach einer sofortigen Verdopplung.
Interessant ist, dass trotz des stabilen CO₂-Wertes im Kontrolllauf eine sehr große Anzahl der Simulationen irgendwo im Verlauf der Kontrollläufe einen „Kipppunkt“ durchlief und offenbar in allen Fällen in eine imaginäre Eiszeit kippte, anstatt in ein „Thermageddon™“ … und das ist in jüngster Zeit ganz offensichtlich nie passiert.
Wie dem auch sei … es handelt sich durch und durch um Modelle, und zwar um Tinkertoy™-Modelle …
Link: https://wattsupwiththat.com/2026/10/22/breaking-models-model-modeled-tipping-points/
Übersetzt von Christian Freuer für das EIKE




Wir freuen uns über Ihren Kommentar, bitten aber folgende Regeln zu beachten:
- Bitte geben Sie Ihren Namen an (Benutzerprofil) - Kommentare "von anonym" werden gelöscht.
- Vermeiden Sie Allgemeinplätze, Beleidigungen oder Fäkal- Sprache, es sei denn, dass sie in einem notwendigen Zitat enthalten oder für die Anmerkung wichtig sind. Vermeiden Sie Schmähreden, andauernde Wiederholungen und jede Form von Mißachtung von Gegnern. Auch lange Präsentationen von Amateur-Theorien bitten wir zu vermeiden.
- Bleiben Sie beim Thema des zu kommentierenden Beitrags. Gehen Sie in Diskussionen mit Bloggern anderer Meinung auf deren Argumente ein und weichen Sie nicht durch Eröffnen laufend neuer Themen aus. Beschränken Sie sich auf eine zumutbare Anzahl von Kommentaren pro Zeit. Versuchte Majorisierung unseres Kommentarblogs, wie z.B. durch extrem häufiges Posten, permanente Wiederholungen etc. (Forentrolle) wird von uns mit Sperren beantwortet.
- Sie können anderer Meinung sein, aber vermeiden Sie persönliche Angriffe.
- Drohungen werden ernst genommen und ggf. an die Strafverfolgungsbehörden weitergegeben.
- Spam und Werbung sind im Kommentarbereich nicht erlaubt.
Diese Richtlinien sind sehr allgemein und können nicht jede mögliche Situation abdecken. Nehmen Sie deshalb bitte nicht an, dass das EIKE Management mit Ihnen übereinstimmt oder sonst Ihre Anmerkungen gutheißt. Wir behalten uns jederzeit das Recht vor, Anmerkungen zu filtern oder zu löschen oder zu bestreiten und dies ganz allein nach unserem Gutdünken. Wenn Sie finden, dass Ihre Anmerkung unpassend gefiltert wurde, schicken Sie uns bitte eine Mail über "Über Uns->Kontakt"